Les meilleurs petits modèles d’IA en local : une boîte à outils compacte pour ton PC portable
Sur un PC portable ordinaire doté de 16 Go de mémoire, le modèle qwen3.5:4b-q4_K_M rédige déjà des textes, explique des notions et répond à des questions du quotidien, sans aucune connexion Internet. C’est le modèle utilisé dans le deuxième volet de cette série. Il fait un bon assistant généraliste. Mais ce n’est pas à lui de chercher aussi dans tes fichiers ni de traiter une tâche de programmation. À vouloir tout confier à un seul modèle, tu finis par le surcharger, alors que trois petits modèles peuvent chacun se rendre utiles.
Garder la main sur ton installation d’IA en local, c’est choisir le modèle, le moteur et la licence, mais aussi décider quelles données conserver et où les stocker. Si tu n’as pas encore vérifié la RAM ou la VRAM de ton PC portable, commence par notre guide sur la mémoire nécessaire pour l’IA en local. Si tu n’as pas encore installé Ollama, notre guide pour configurer ton premier fournisseur d’IA en local te montre comment t’y prendre. Ce guide part du principe que tu as fait les deux. Reste à choisir les modèles et à voir ce qu’ils valent.
Petits modèles d’IA en local : les meilleurs selon la tâche
Une boîte à outils d’IA en local utile, c’est trois modèles pour trois tâches distinctes, plutôt qu’un seul chargé de tout faire.
Un assistant généraliste, pour discuter au quotidien, rédiger et répondre aux questions rapides : qwen3.5:4b-q4_K_M. Il faut télécharger 3,4 Go ; le tag est le même que dans le deuxième volet.
Un spécialiste compact, pour une tâche plus ciblée, comme produire des réponses structurées ou résoudre un problème de raisonnement bien délimité : granite4.2:3b. Publié en août 2026 sous licence Apache 2.0, il nécessite un téléchargement de 2,2 Go. La section 6 présente d’autres spécialistes pour le code, les maths, l’analyse d’images et la traduction : tu peux remplacer ce modèle par celui qui correspond à ta tâche.
Un modèle d’embeddings, pour chercher dans tes propres documents : embeddinggemma:300m. Il faut télécharger 622 Mo. Ce modèle ne discute pas avec toi : il transforme le texte en vecteurs qu’une application de recherche parcourt. La section 8 explique son fonctionnement en détail.
Sur le disque, ces trois téléchargements occupent environ 6,2 Go. Ce total ne correspond pas à la mémoire nécessaire pour les charger ensemble : garder les trois modèles en mémoire peut dépasser la mémoire libre de ton PC portable. En pratique, charge un modèle à la fois selon la tâche, évalue-le sur un cas réel et supprime ceux qui ne te sont pas utiles.
Ce que change la quantification
Pour comprendre la quantification, le plus simple est de comparer les variantes d’un même modèle. Dans le catalogue Ollama, la version qwen3.5:9b-q4_K_M pèse 6,6 Go au téléchargement, la version qwen3.5:9b-q8_0 11 Go et la version qwen3.5:9b-bf16 19 Go. Les mêmes poids, mais trois niveaux de précision et trois tailles de téléchargement.
Ces chiffres indiquent la taille des fichiers à télécharger, pas la mémoire que le modèle occupera une fois chargé. Une précision moindre réduit la taille du fichier et, souvent, l’occupation mémoire une fois le modèle chargé. Une éventuelle baisse de qualité des réponses dépend toutefois du modèle, de l’outil de quantification et de la tâche. Ne pars pas du principe que la qualité restera intacte ou que le gain de place est sans contrepartie.
Les poids chargés ne sont pas les seuls à occuper de la mémoire. Il faut aussi en réserver à la fenêtre de contexte, à son cache clé-valeur et aux autres programmes en cours d’exécution. Même quand elle libère de la mémoire, la quantification ne garantit pas qu’un modèle plus grand tiendra sur ton PC portable. Elle rend simplement l’essai plus envisageable que si tu commençais par le fichier en pleine précision.
Deux pièges dans les noms qui te font télécharger le mauvais modèle
Deux indications du catalogue prêtent à confusion : si tu interprètes mal l’une ou l’autre, tu téléchargeras le mauvais modèle.
Premier piège. Sur sa fiche, Google présente Gemma 4 E2B comme un modèle comptant 2,3 milliards de paramètres linguistiques « effectifs ». On pourrait donc s’attendre à un petit fichier. Pourtant, son téléchargement sur Ollama pèse 7,2 Go, presque autant que celui du tag Q4 de gemma4:12b (7,6 Go). Pour savoir ce que ton PC portable peut accueillir, regarde la taille du téléchargement, pas le nombre de paramètres affiché.
Deuxième piège. Un tag sans autre précision peut sélectionner un autre modèle sans que tu t’en aperçoives. Si tu télécharges le tag granite4.2 sans autre précision, tu obtiens le modèle 8B de 5,3 Go, et non le tag 3B de 2,2 Go présenté à la section 2. Même chose avec le tag qwen3-embedding : sans autre précision, tu obtiens le modèle 8B de 4,7 Go, et non le tag 0.6B de 639 Mo utilisé à la section 8.
Dans les deux cas, télécharge toujours le tag exact et complet, jamais seulement le nom de la famille. Vérifie aussi la taille du fichier téléchargé avant de considérer que tu as bien le modèle que tu voulais tester.
La fenêtre de contexte par défaut d’Ollama
Quand un catalogue annonce une fenêtre de contexte maximale de 128K ou 256K tokens, il indique ce que le modèle peut accepter en principe. Rien ne garantit que les 16 Go de mémoire de ton PC portable suffisent pour l’exploiter.
Ollama règle par défaut la fenêtre de contexte sur 4 096 tokens. Tu peux augmenter cette valeur, mais un contexte plus long et davantage de requêtes simultanées consomment plus de mémoire. Le réglage num_ctx: 4096 du deuxième volet correspond à cette valeur prudente : ce n’est pas un nombre rond choisi au hasard.
Pour essayer un nouveau modèle, pars sur 4 000 à 8 000 tokens et fais tourner une seule session à la fois. Garde un œil sur l’occupation de la mémoire système : n’allonge le contexte qu’après avoir constaté qu’elle reste stable, pas simplement parce que le catalogue indique que c’est techniquement possible.
Quel petit modèle d’IA choisir pour une tâche spécialisée ?
Il n’y a pas de meilleur modèle spécialisé dans l’absolu : tout dépend de la tâche. Voici quelques petits modèles à tester.
Code : qwen2.5-coder:3b (1,9 Go) ou le plus grand qwen2.5-coder:7b (4,7 Go), tous deux sous licence Apache 2.0.
Problèmes de maths ou de logique bien délimités : phi4-mini:3.8b (2,5 Go), de Microsoft.
Questions sur des images et des captures d’écran : gemma4:e2b (7,2 Go) ou gemma4:12b en Q4 (7,6 Go). Les deux sont sous licence Apache 2.0 ; leurs fiches indiquent qu’ils acceptent du texte et des images en entrée.
Rédaction multilingue ou traduction : aya-expanse:8b (5,1 Go), conçu pour 23 langues.
La licence du modèle Aya Expanse 8B n’est pas un détail à reléguer en note de bas de page : elle relève de CC-BY-NC-4.0, avec des conditions supplémentaires, et réserve le modèle à un usage non commercial. Ne le considère pas comme un choix par défaut sans restriction, au même titre que les modèles sous licence Apache cités plus haut. Si ta tâche ne correspond à aucun de ces quatre cas, le modèle granite4.2:3b, présenté à la section 2, reste notre choix généraliste pour le raisonnement.
Teste chaque candidat sur ta propre tâche avant de te décider. Comme pour l’assistant généraliste, un spécialiste mérite sa place s’il t’aide à accomplir ta tâche, pas s’il arrive en tête du classement de quelqu’un d’autre.
Cinq tests à reproduire avant de faire confiance à un modèle
Cinq tests courts t’en apprendront plus sur un modèle que n’importe quelle fiche de catalogue. Fais-les passer à chaque modèle que tu compares, avec tes propres exemples.
1. Un résumé fidèle au texte. Fournis au modèle une note de 250 mots et demande-lui trois actions à entreprendre, accompagnées chacune de la phrase de la note dont elle découle. Relève toute affirmation qui n’est pas étayée par la note.
2. Une extraction structurée. Invente cinq rendez-vous avec des noms et des dates. Demande une réponse au format JSON contenant exactement les champs que tu as définis, puis compare les cinq résultats aux rendez-vous que tu as inventés.
3. Une correction de code. Soumets au modèle une petite fonction qui échoue et un test. Note si le test passe après la correction qu’il propose, en utilisant le même dépôt de code et le même contexte pour chaque modèle comparé.
4. Une traduction entre deux langues. Fais vérifier par une personne qui maîtrise la langue d’arrivée qu’un paragraphe réaliste conserve ses noms, ses chiffres et ses nuances après traduction. Ne juge jamais la qualité multilingue d’un modèle à partir d’une consigne rédigée uniquement en anglais.
5. Une question sur une image, uniquement pour les modèles capables d’analyser des images. Soumets un graphique ou une capture d’écran en posant une question dont la réponse peut être vérifiée. Assure-toi d’avoir bien envoyé l’image elle-même, pas seulement son nom de fichier.
Pour chaque essai, note l’exactitude de la réponse par rapport à la réponse connue, le respect des consignes, les éléments inventés, le délai avant le premier résultat visible, le temps total et le nombre de tokens, et précise si le modèle a tourné sur CPU ou GPU. Évalue séparément l’utilité et la vitesse : un modèle qui raisonne avant de répondre peut passer du temps à produire des tokens que tu ne verras jamais.
Un petit outil de recherche dans tes documents (RAG local)
Le modèle d’embeddings présenté à la section 2 sert uniquement à convertir du texte en vecteurs pour permettre à une application de retrouver des passages. À lui seul, il ne répond pas aux questions.
Tout se passe dans cet ordre : tes fichiers sont d’abord découpés en fragments. Le modèle d’embeddings transforme chaque fragment en vecteur, puis une base vectorielle locale stocke ces vecteurs. Ta question est convertie à son tour en vecteur, et l’application retrouve les fragments les plus proches. Ce n’est qu’alors qu’un modèle conversationnel répond en s’appuyant sur les passages retrouvés et en les citant.
Le modèle conversationnel n’a jamais été entraîné sur tes documents. Au moment où tu poses ta question, il n’a accès qu’à ce que lui transmet l’étape de recherche.
Une petite démonstration suffit à vérifier le principe, sans beaucoup de préparation : indexe cinq notes que tu as déjà. Pose une question dont la réponse figure dans l’une d’elles, puis une autre dont la réponse ne figure dans aucune des cinq. Si tout fonctionne, le système retrouve et cite le bon passage pour la première question. Pour la seconde, il reconnaît qu’il n’a aucun élément pour répondre, au lieu d’inventer une réponse. Évalue séparément la recherche des passages et la réponse finale.
Avant de télécharger le modèle d’embeddings, vérifie son tag exact : embeddinggemma:300m ou qwen3-embedding:0.6b. Comme à la section 4, le seul nom de la famille risque de te faire télécharger un autre modèle.
Moins de paramètres actifs ne signifie pas moins de données à stocker
Un modèle portant une étiquette comme « 26B A4B » ne fait appel qu’à une partie de ses paramètres pour générer chaque token. Ses 26 milliards de poids doivent pourtant être stockés quelque part, ou chargés en continu. Avoir moins de paramètres actifs ne garantit donc ni un fichier plus petit ni une occupation mémoire plus faible.
Cette boîte à outils ne présente aucun nouveau chiffre issu de tests de performance. Un résultat rapporté ailleurs reste lié au matériel utilisé : une personne indique par exemple avoir obtenu environ 18,5 tokens par seconde avec un modèle à mélange d’experts de 26 milliards de paramètres, sur une configuration inhabituelle dotée d’un ancien processeur et d’un GPU de 6 Go. C’est le résultat obtenu sur son propre matériel, pas une vitesse à attendre de tous les modèles portant cette étiquette.
Les deux PC portables qui ont servi à nos essais
Nous avons testé cette boîte à outils sur deux PC portables qu’on trouve aujourd’hui, les mêmes que dans le deuxième volet de la série : un modèle d’entrée de gamme équipé d’une puce Apple Silicon et une station de travail sous Windows dotée d’une mémoire graphique dédiée. Tous deux sont reconditionnés (testés, nettoyés et remis en état par des professionnels) et bénéficient d’une garantie de 12 mois chez refurbed. Chacun permet de faire tourner confortablement cette boîte à outils, un modèle à la fois.
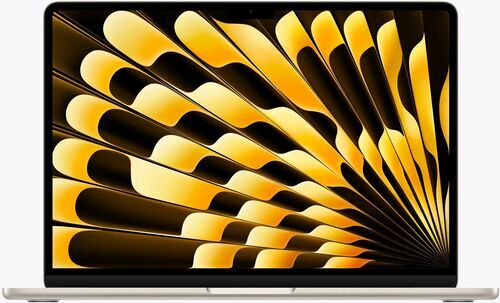
Le MacBook Air 13 pouces (2026) avec puce M5 dispose de 16 Go de mémoire unifiée de série, une capacité qui peut monter à 32 Go selon la configuration. Le Dell Precision 7730 associe 32 Go de mémoire système à 6 Go de VRAM NVIDIA dédiée : il s’agit de deux réserves de mémoire distinctes, dont les capacités ne s’additionnent pas.
Le but n’est pas de te vendre l’un ou l’autre. Ces deux machines sont nos points de repère pour ce guide : tu peux ainsi comparer ton propre PC portable à des configurations concrètes plutôt qu’à une fiche technique commerciale.

Licences et choix des modèles : fais régulièrement le point
La licence se vérifie pour chaque modèle, pas pour toute sa famille. Les modèles Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B et Gemma 4 E2B sont tous sous licence Apache 2.0. Le modèle Aya Expanse 8B relève de la licence CC-BY-NC-4.0, avec des conditions supplémentaires et une restriction aux usages non commerciaux, comme indiqué à la section 6. Il faut distinguer trois choses : pouvoir télécharger les poids d’un modèle, avoir le droit de les utiliser au regard du droit d’auteur et « posséder » le modèle lui-même. Vérifie la fiche à jour du modèle précis que tu télécharges, sans te fier au seul nom de sa famille.
Pour garder une petite sélection de modèles, il faut faire le tri régulièrement. ollama rm supprime un modèle téléchargé dont tu n’as pas l’utilité : par exemple, ollama rm aya-expanse:8b si tu sais que tu ne l’utiliseras pas. ollama ls indique les modèles présents sur le disque et ollama ps ceux chargés en mémoire. Les catalogues évoluent : revois ta sélection plutôt que de te fier à un choix fait il y a plusieurs mois.
Même un petit modèle peut inventer un passage, passer à côté d’une nuance dans une autre langue ou produire du code qui semble correct mais échoue au test. Considère chaque recommandation de ce guide comme une piste à tester toi-même. Quand l’enjeu est important, elle ne remplace jamais une vérification par un spécialiste.
Les meilleurs petits modèles d’IA en local : questions fréquentes
Puis-je faire tourner les trois modèles de la boîte à outils en même temps ? Sans doute pas dans de bonnes conditions sur un PC portable doté de 16 Go de mémoire. Charge le modèle dont tu as besoin pour la tâche en cours, puis passe au suivant, plutôt que de garder en mémoire à la fois l’assistant généraliste, le spécialiste et le modèle d’embeddings.
Faut-il un GPU pour le modèle d’embeddings ? Non. Le modèle embeddinggemma:300m est assez petit pour être testé avec le seul CPU. Mesure tout de même le temps qu’il met à s’exécuter, sans supposer que ce sera instantané.
Un modèle plus grand donne-t-il toujours une meilleure réponse ? Non. Selon la tâche, un modèle 4B peut faire mieux qu’un 9B, ou l’inverse. Voilà pourquoi la section 7 propose cinq tests, plutôt que de s’en remettre à un seul chiffre dans un classement.
La version Q4 d’un modèle suffit-elle ? Cela dépend de la tâche. Si tu as assez de mémoire pour faire tourner les deux versions, compare le tag Q4 à son équivalent Q8 à l’aide de trois tests que tu auras préparés toi-même, comme à la section 3.
Puis-je utiliser Aya Expanse pour un projet commercial ? Pas par défaut. Sa licence CC-BY-NC-4.0 couvre les usages non commerciaux et comporte des conditions supplémentaires. Consulte la fiche à jour du modèle avant de supposer que tu peux l’utiliser pour un projet commercial.
Le modèle d’embeddings a-t-il besoin d’Internet une fois téléchargé ? Non. Comme tous les autres modèles de cette boîte à outils, il fonctionne hors connexion une fois ses poids sur le disque.
À toi de jouer : installe, teste et garde les modèles qui te servent
Le premier volet t’a aidé à évaluer les besoins en mémoire de ton PC portable, le deuxième à y configurer l’IA en local. Installe-y maintenant l’assistant 4B et un spécialiste adapté à une tâche que tu as à accomplir. Fais ta propre version des tests de la section 7, avec trois questions de ton choix. Garde le modèle qui t’aide et supprime l’autre avec ollama rm. N’envisage d’acheter plus de mémoire qu’après avoir vérifié, sur une tâche réelle et non à partir d’une fiche technique, que c’est bien la mémoire qui te limite.
Ce guide clôt notre série en trois volets. Si tu as constaté que ton PC portable manque avant tout de mémoire, tu peux commencer par parcourir notre catégorie de PC portables.

Inscrivez-vous à notre newsletter pour la première fois et économisez CHF 15 !
Ne manquez plus aucune offre.
Retrouvez les informations sur l'utilisation des données personnelles dans notre politique de confidentialité.
Téléchargez l'application refurbed
Pour iOS et Android


Confirmer l'inscription
Cliquez sur le lien dans notre e-mail de confirmation pour recevoir votre bon d'achat. Il sera valable pour tout achat supérieur à CHF 200.
- © Refurbed Marketplace GmbH
- Accessibilités
- CGU
- Politique de confidentialité
- Mentions légales
- Legal Notices
- Cookie Policy