De combien de RAM ton ordinateur portable a-t-il besoin pour faire tourner l’IA en local ?
Sur votre propre ordinateur portable, un petit modèle d’IA peut déjà lire du texte, interpréter des images et répondre à vos questions sans avoir besoin d’un compte cloud. Ce soir, téléchargez qwen3.5:4b-q4_K_M (Qwen), un modèle de 3,4 Go qui peut faire exactement cela sur un ordinateur portable ordinaire doté de 16 Go de mémoire. C’est un LLM, ou grand modèle de langage. Télécharge-le via Ollama, pose-lui une question avec un contexte de 4K, et tu fais déjà tourner un vrai modèle d’IA en local sur ta machine actuelle. Il lit du texte et des images. Ici, on parle d’inférence, pas d’entraînement : on n’apprend rien de nouveau au modèle, qui se contente de répondre.
Un autocollant aussi vague que « AI PC » sur la boîte d’un ordinateur portable ne remplace pas une fiche technique. Ce qui compte, c’est la RAM, la mémoire exploitable par le GPU, le stockage et la compatibilité logicielle réelle. Avec 16 Go de mémoire, tu as déjà un vrai point d’entrée pour les petits modèles d’IA. Ce n’est ni une capacité à écarter d’office, ni la garantie de pouvoir faire tout ce qu’annonce une fiche technique. Plus de mémoire, c’est plus de contexte et davantage de marge pour le multitâche. Avec 16 Go, tu peux déjà commencer.
Ce qui utilise la RAM de ton ordinateur portable quand tu lances de l’IA
La taille de téléchargement d’un modèle et la mémoire qu’il occupe une fois lancé sont deux choses bien différentes. Les confondre, c’est de loin l’erreur la plus fréquente quand on cherche un ordinateur portable pour l’IA. Les 3,4 Go que tu télécharges pour qwen3.5:4b-q4_K_M correspondent au fichier stocké sur le disque. Pour le charger, il faut de la mémoire disponible. Il en faut aussi pour la fenêtre de contexte, autrement dit la conversation en cours que le modèle garde en tête pendant qu’il répond, ce qu’on appelle le cache KV. Et il en faut encore pour le moteur lui-même, sans compter ce que ton système d’exploitation et tes autres applis utilisent déjà.
Par défaut, Ollama charge un contexte de 4 096 tokens, et tu peux l’augmenter. Si tu exécutes plusieurs requêtes en parallèle, la mémoire nécessaire pour le contexte augmente à peu près au même rythme que le nombre de requêtes simultanées. La fiche technique d’un modèle peut annoncer une fenêtre de contexte de 128K ou 256K tokens : vois-y le plafond du modèle, pas la promesse que ton ordinateur portable de 16 Go pourra exploiter toute cette capacité d’un coup.
RAM, VRAM et mémoire unifiée : trois réalités distinctes
Les puces Apple Silicon utilisent une mémoire unifiée : le CPU et le GPU puisent dans la même réserve de 16, 24 ou 32 Go. Il n’y a donc pas de mémoire graphique séparée susceptible de manquer. Sur un ordinateur portable classique sous Windows ou Linux, doté d’un GPU NVIDIA dédié, c’est différent. La RAM système et la VRAM du GPU forment deux réserves distinctes, et 16 Go de RAM système avec un GPU de 8 Go ne constituent pas un seul bloc de 24 Go qu’un modèle peut utiliser librement.
Quand un modèle ne tient pas entièrement sur le GPU, une partie s’exécute sur le CPU. Cette répartition partielle peut rendre un modèle techniquement chargeable nettement plus lent à l’usage. Exécute la commande ollama ps : elle t’indiquera précisément la répartition CPU/GPU du modèle actuellement chargé.
La capacité ne fait pas tout. La vitesse de transfert des données compte tout autant : Apple annonce 153 Go/s de bande passante mémoire sur le MacBook Air M5. C’est aussi cette bande passante, et pas seulement la quantité de mémoire, qui explique pourquoi la mémoire unifiée reste fluide au quotidien plutôt que d’être simplement suffisante sur le papier.
Quantification : comment un modèle d’IA 9B rétrécit pour tenir dans ta RAM
La quantification, c’est ce qui se cache derrière ce téléchargement de 3,4 Go : en stockant les poids d’un modèle avec une précision numérique plus faible, on réduit la taille du fichier. Le modèle 9B de Qwen3.5 illustre très bien cet écart. Le même modèle 9B se télécharge en 6,6 Go en Q4_K_M, en 11 Go en Q8_0 et en 19 Go en pleine précision BF16. Même modèle, même nombre de paramètres, trois tailles de téléchargement très différentes. Et là encore, il s’agit de la taille du fichier, pas de la RAM nécessaire pendant l’exécution.
En général, une précision plus faible entraîne une petite perte de qualité, mais son ampleur dépend de la tâche, pas d’un pourcentage fixe. Autre détail concret à connaître avant de choisir Qwen comme premier modèle : certains utilisateurs signalent que son étape de « réflexion » retarde sensiblement l’affichage de la réponse par rapport à des modèles qui répondent plus directement. Mieux vaut tester les deux approches sur tes propres usages plutôt que de partir du principe que l’une est forcément meilleure.
Tu as déjà un MacBook avec 16 Go de mémoire ? Essaie d’abord ça avant d’acheter quoi que ce soit
Si tu as déjà un MacBook doté de 16 Go de mémoire, commence par un modèle 2–4B en précision Q4 avec un contexte de 4K avant d’envisager le moindre achat. Un modèle 9B en Q4, ou quelque chose comme Gemma 4 12B QAT, peut aussi se charger. Que cela fonctionne ou non dépend du nombre d’applis déjà ouvertes, de la quantité de contexte utilisée et de la charge thermique de la machine à ce moment-là. Vois donc ça comme une piste à tester, pas comme une garantie.
Tu veux acheter un modèle neuf spécialement pour ça ? Le MacBook Air 13 pouces avec puce M5 est livré de série avec 16 Go de mémoire unifiée et peut être configuré jusqu’à 32 Go. Et avant de te laisser tenter par le plus grand écran comme solution de mise à niveau, un point à garder en tête : le modèle M5 Air 15 pouces démarre exactement avec les mêmes options de 16, 24 et 32 Go de mémoire, ainsi que la même bande passante de 153 Go/s que la version 13 pouces. Choisis la taille d’écran pour ton confort, pas en pensant gagner plus de marge pour l’IA. Ce n’est pas le cas.

Tu as déjà un ordinateur portable Windows ou Linux avec 16 Go ? Commence ici
Un ordinateur portable sous Windows ou Linux avec 16 Go de mémoire et sans GPU dédié peut malgré tout faire tourner un petit modèle. Ollama fonctionne nativement sur Windows : télécharge un modèle 2–4B en Q4 et essaie-le sur le CPU ou sur la partie graphique intégrée avant de dépenser quoi que ce soit. Attends-toi à plus de variations qu’avec Apple Silicon : aucun chiffre fixe en tokens par seconde ne vaut pour toutes les machines, tout simplement parce que personne n’a mesuré toutes les configurations possibles.
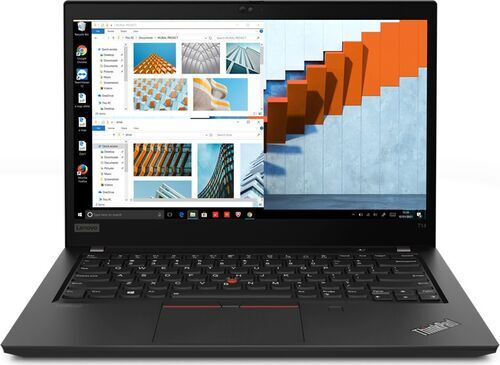
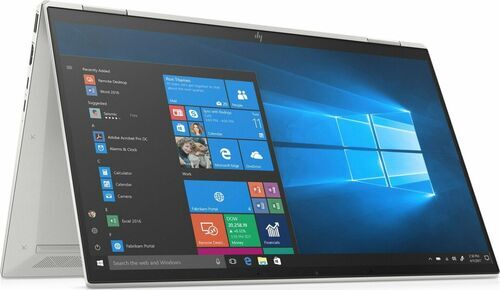
Le Lenovo ThinkPad T14 G2 et le HP EliteBook x360 1040 G7 embarquent tous deux 16 Go de RAM avec une partie graphique intégrée, exactement dans cette catégorie. Un point à vérifier d’abord, surtout sur une machine reconditionnée plus ancienne comme ces deux modèles : LM Studio exige la prise en charge d’AVX2 sous Windows x64, un jeu d’instructions que tous les anciens processeurs ne prennent pas en charge. Vérifie que le processeur de ton modèle précis le gère avant de supposer que n’importe quel ordinateur portable de cette gamme fera tourner l’outil que tu as choisi.
Le piège des noms de GPU pour ordinateur portable : pourquoi « RTX 5070 Ti » ne dit pas tout
Les GPU NVIDIA pour ordinateurs portables portent les mêmes noms que les cartes pour ordinateurs de bureau, et ce nom en dit moins qu’on ne le croit. Le RTX 5060 Laptop GPU dispose de 8 Go de mémoire GDDR7 et d’une plage de puissance annoncée de 45 à 100 watts. Le RTX 5070 Ti Laptop GPU dispose de 12 Go de GDDR7 et de 60 à 115 watts. Un résultat trouvé en ligne pour une RTX 5070 Ti de bureau n’équivaut pas à un résultat obtenu avec une RTX 5070 Ti pour ordinateur portable, quoi qu’en laisse penser le nom.
Un deuxième piège se cache dans ce même nom. Deux ordinateurs portables peuvent tous deux intégrer un « RTX 5070 Ti Laptop GPU » et pourtant offrir des performances différentes en charge prolongée : un châssis fin et léger ne gère pas la chaleur comme un modèle plus épais et plus lourd. Le même nom de GPU ne garantit donc pas la même vitesse réelle après une période prolongée sous charge. Vérifie toujours la quantité exacte de VRAM et la configuration de puissance propre à l’ordinateur portable, jamais le seul nom de la famille de GPU.
Tu achètes un Mac neuf ? Le palier confortable en mémoire unifiée
Si tu achètes un ordinateur portable spécialement pour faire tourner régulièrement de l’IA en local, 24 à 32 Go de mémoire unifiée constituent le palier Apple le plus confortable : tu gardes une vraie marge pour un modèle plus gros, un contexte plus long, ou tout simplement pour laisser d’autres applis ouvertes pendant que tu travailles. Vise 32 Go si tu comptes t’en servir souvent et que le budget le permet.
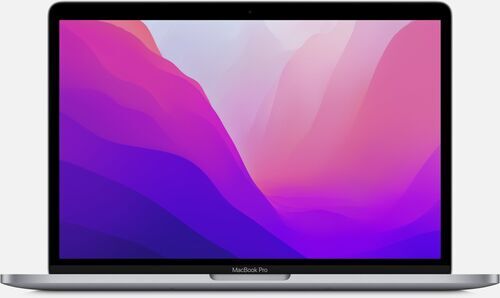
Le MacBook Pro 13 pouces avec puce M2 en est un bon exemple reconditionné, déjà au-dessus du palier d’entrée à 16 Go : avec un CPU à 8 cœurs et un GPU à 10 cœurs, il peut accueillir jusqu’à 24 Go de mémoire unifiée. Il appartient à une génération de puces plus ancienne que le M5 Air, donc son plafond de 24 Go est bien ce qu’il faut attendre ici, et non les options distinctes de 24 ou 32 Go du M5 Air.
Tu achètes un ordinateur portable Windows ou Linux neuf ? Cherche un GPU dédié
Pour un achat Windows ou Linux neuf pensé autour de l’IA en local, vise 32 Go de RAM système avec un GPU NVIDIA pour ordinateur portable doté d’au moins 8 Go de VRAM dédiée, et 12 Go si tu acceptes un ordinateur portable un peu plus lourd ou plus cher. 8 Go peuvent suffire pour des modèles 4–7B en précision Q4 avec un contexte modéré, mais n’y vois pas une marge automatique : même avec un téléchargement de 6,6 Go, un modèle 9B en Q4 peut demander plus de 8 Go pour tourner confortablement, et 12 Go rendent les essais plus faciles à cette taille.
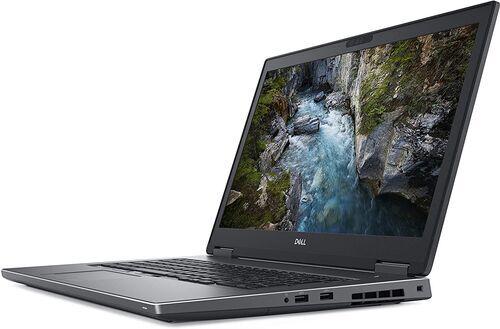
Le Dell Precision 7730 est un exemple reconditionné très concret de cette logique, même s’il n’embarque pas exactement les nouvelles puces citées plus haut : ses 32 Go de mémoire système s’ajoutent à un GPU NVIDIA Quadro P3200 dédié, doté de 6 Go de VRAM. Il s’agit d’une génération et d’une catégorie de GPU différentes des actuels RTX 5060 et 5070 Ti Laptop GPU de NVIDIA, mais le principe des pools séparés reste le même.

Une autre piste sérieuse : les puces pour ordinateurs portables AMD à grande capacité mémoire
Le processeur Ryzen AI Max+ 395 d’AMD prend en charge jusqu’à 128 Go de mémoire système LPDDR5x, selon la configuration retenue sur l’ordinateur portable final. C’est une architecture mémoire différente qu’il vaut la peine de connaître, avec une vraie limite à garder en tête : la liste de compatibilité ROCm Linux d’Ollama mentionne cette puce, alors que la liste ROCm Windows ne la cite pas à l’heure actuelle.
Voilà une bonne raison de vérifier, sur un ordinateur portable précis, la quantité de mémoire installée, le système d’exploitation, le backend GPU, le pilote et le comportement d’Ollama avant de le recommander. Ce n’est pas une raison pour écarter d’emblée cette puce. Considère plutôt un ordinateur portable AMD à grande capacité mémoire comme une architecture alternative intéressante à étudier de près, et non comme le premier achat par défaut pour quelqu’un qui débute avec l’IA en local.
La couche logicielle : Ollama et LM Studio, en bref
Ollama est la solution la plus simple pour échanger avec un modèle sur ta propre machine : tu télécharges un modèle, tu le lances, et tu obtiens un serveur local qui répond aux requêtes, sans avoir besoin d’un compte cloud si le modèle est déjà téléchargé. C’est l’outil utilisé dans tous les exemples ici.
LM Studio propose une alternative graphique avec son propre navigateur de modèles et sa fenêtre de chat. L’outil publie ses exigences minimales : au moins 16 Go de RAM sur Mac ou Windows, prise en charge d’AVX2 obligatoire sur Windows x64, et 4 Go de VRAM dédiée recommandés sur Windows. Bien configurer l’un ou l’autre est un sujet à part entière.
Un point de vigilance avant de te fier à un seul chiffre de vitesse vu en ligne : l’outil officiel llama-bench distingue la vitesse de traitement du prompt de la vitesse de génération et publie les variations observées sur plusieurs essais, plutôt qu’un seul nombre. Un message de forum qui cite un seul chiffre de tokens par seconde précise rarement lequel des deux a été mesuré, ni combien de fois le test a été lancé.
Avant d’acheter ou d’améliorer ton ordinateur portable pour l’IA : vérifie ces points
Avant d’acheter ou d’améliorer un ordinateur portable spécifiquement pour l’IA en local, vérifie les points concrets plutôt que le marketing.
Modèle exact du GPU et quantité de VRAM. Pas seulement le nom de la famille de GPU : vérifie la variante précise de l’ordinateur portable et sa quantité de mémoire, car un même nom peut cacher plusieurs capacités de VRAM.
RAM soudée ou évolutive. Certains ordinateurs portables permettent d’ajouter de la mémoire plus tard ; beaucoup de modèles fins et légers modernes ne le permettent pas. Mieux vaut le savoir avant d’acheter.
Espace SSD disponible. Les téléchargements de modèles vont de moins d’un gigaoctet à bien plus de dix gigaoctets, et une bibliothèque de modèles qui s’agrandit prend vite de la place aux côtés de tes autres fichiers.
Comportement thermique en charge prolongée. Un modèle qui répond à une seule question et un ordinateur portable qui enchaîne plusieurs requêtes à la suite ne passent pas le même test. Le bruit des ventilateurs et la baisse de fréquence après plusieurs prompts en disent plus qu’une simple démo rapide.
Prise en charge du système d’exploitation et des pilotes. Vérifie que la combinaison exacte de backend GPU et de système d’exploitation est bien prise en charge par Ollama ou LM Studio avant de partir du principe que ça fonctionnera.
Le chiffre TOPS du NPU affiché sur la boîte ne garantit aucun débit réel. C’est un argument marketing, pas un résultat mesuré avec le moteur que tu utiliseras. Un vague label « AI PC » ne remplace aucun des contrôles ci-dessus.
Cinq ordinateurs portables reconditionnés à comparer selon ces paliers

Questions fréquentes sur l’IA en local sur ordinateur portable
Ai-je besoin d’un GPU dédié pour faire tourner l’IA en local ?
Non. Un petit modèle peut tourner sur le CPU ou sur la partie graphique intégrée de nombreux ordinateurs portables dotés de 16 Go de mémoire, simplement avec plus de variations de vitesse que sur un ordinateur portable doté d’un GPU dédié. Commence par un modèle 2–4B avant de supposer que tu as absolument besoin d’une carte graphique dédiée.
Est-ce que 8 Go de RAM suffisent ?
Pas confortablement pour les modèles abordés ici. 16 Go constituent le vrai point de départ réaliste dès lors qu’il faut partager la mémoire entre le modèle, sa fenêtre de contexte, le moteur et le système d’exploitation.
Faire tourner un modèle en local, est-ce la même chose que l’entraîner ?
Non. Tout ce qui précède relève de l’inférence : on pose des questions à un modèle déjà entraîné. L’entraînement consiste à construire un modèle à partir de zéro et demande bien plus de matériel que n’importe quel ordinateur portable mentionné ici.
Plus de RAM garantit-il des réponses plus rapides ?
Non. Plus de mémoire offre davantage de marge pour des modèles plus gros, un contexte plus long et plus d’applis ouvertes, mais la vitesse réelle dépend de la bande passante mémoire, du backend GPU et du modèle précis, pas de la seule quantité de mémoire.
Mes données restent-elles privées lorsqu’un modèle tourne en local ?
Oui, dans le sens où tes prompts restent sur ta machine au lieu d’être envoyés à un fournisseur cloud. Par défaut, Ollama n’est accessible que sur ton propre ordinateur portable et n’envoie rien ailleurs, sauf si tu configures volontairement un accès cloud.
Essaie ce soir, puis achète en toute confiance
Tu as déjà un ordinateur portable avec 16 Go de mémoire ? Installe Ollama ce soir et lance un petit modèle avant de dépenser le moindre euro pour du nouveau matériel. Tu achètes spécialement pour ça ? Appuie-toi sur la liste des points à vérifier ci-dessus, ainsi que sur les cinq ordinateurs portables reconditionnés que nous venons de voir, pour établir une première comparaison plutôt que de te fier à une fiche marketing.
Chaque ordinateur portable sur refurbed est testé et évalué avant sa mise en ligne, donc la RAM et la configuration que tu achètes sont bien celles que tu reçois. Le prochain guide de cette série t’explique comment connecter ta première appli au modèle que tu viens d’essayer.


Inscrivez-vous à notre newsletter pour la première fois et économisez CHF 15 !
Ne manquez plus aucune offre.
Retrouvez les informations sur l'utilisation des données personnelles dans notre politique de confidentialité.
Téléchargez l'application refurbed
Pour iOS et Android


Confirmer l'inscription
Cliquez sur le lien dans notre e-mail de confirmation pour recevoir votre bon d'achat. Il sera valable pour tout achat supérieur à CHF 200.
- © Refurbed Marketplace GmbH
- Accessibilités
- CGU
- Politique de confidentialité
- Mentions légales
- Legal Notices
- Cookie Policy