Die besten kleinen KI-Modelle lokal nutzen: ein kompaktes Toolkit für deinen Laptop
Schon jetzt formuliert qwen3.5:4b-q4_K_M auf einem gewöhnlichen Laptop mit 16 GB RAM Texte, erklärt Dinge und beantwortet alltägliche Fragen – ganz ohne Internetverbindung. Du kennst das Modell aus Teil 2 dieser Reihe. Als allgemeiner Assistent ist es eine solide Wahl. Für die Suche in deinen Dateien oder für Programmieraufgaben solltest du jedoch andere Modelle einsetzen. Wer für alles nur einen Download nutzt, verlangt einem einzigen Modell zu viel ab. Sinnvoller sind drei kleine Modelle, die sich jeweils für ihre Aufgabe bewähren.
Bei deiner lokalen KI-Umgebung entscheidest du selbst und bewusst, welches Modell und welche Laufzeitumgebung du nutzt, welche Lizenz gilt und welche Daten wo bleiben. Wenn du RAM und VRAM deines Laptops noch nicht geprüft hast, lies zuerst, wie viel RAM dein Laptop für lokale KI braucht. Falls Ollama noch nicht installiert ist, zeigt dir die Anleitung zum Einrichten deines ersten lokalen KI-Providers, wie das geht. Hier setzen wir beides voraus und zeigen dir, welche Modelle sich lohnen und wie du herausfindest, ob sie etwas taugen.
Die besten kleinen KI-Modelle für den lokalen Einsatz – je nach Aufgabe
Für ein brauchbares lokales KI-Toolkit brauchst du drei Modelle für unterschiedliche Aufgaben – nicht eines für alles.
Ein allgemeiner Assistent für alltägliche Gespräche, Textentwürfe und kurze Fragen: qwen3.5:4b-q4_K_M. Der Download ist 3,4 GB gross; den Tag kennst du bereits aus Teil 2.
Ein kompaktes Spezialmodell für eng umrissene Aufgaben, etwa strukturierte Ausgaben oder logische Schlussfolgerungen nach festen Vorgaben: granite4.2:3b. Der Download ist 2,2 GB gross. Das Modell erschien im August 2026 und steht unter der Apache-2.0-Lizenz. Weitere Spezialmodelle für Code, Mathematik, Bildverarbeitung und Übersetzungen stellen wir in Abschnitt 6 vor. Je nach Aufgabe kannst du das Spezialmodell in deinem Toolkit durch eines davon ersetzen.
Ein Embedding-Modell für die Suche in deinen eigenen Dokumenten: embeddinggemma:300m. Der Download ist 622 MB gross. Mit diesem Modell kannst du nicht chatten. Stattdessen wandelt es Text in Vektoren um, die eine Suchanwendung durchsucht. Wie das funktioniert, erklären wir ausführlich in Abschnitt 8.
Die drei Downloads belegen zusammen rund 6,2 GB auf der Festplatte. Daraus lässt sich ihr gemeinsamer Speicherbedarf im Betrieb nicht ablesen: Wenn alle drei Modelle gleichzeitig geladen sind, kann der freie Speicher deines Laptops trotzdem nicht ausreichen. Lade deshalb jeweils nur das passende Modell, teste es an einer echten Aufgabe und entferne Modelle, die sich nicht bewähren.
Quantisierung: was sich ändert und was nicht
Wie sich Quantisierung auswirkt, lässt sich gut an Varianten desselben Modells erkennen. Bei Ollama ist qwen3.5:9b-q4_K_M als Download 6,6 GB gross, qwen3.5:9b-q8_0 11 GB und qwen3.5:9b-bf16 19 GB. Die zugrunde liegenden Modellgewichte sind gleich – ihre Präzision und Downloadgrösse unterscheiden sich.
Im Katalog steht die Downloadgrösse. Wie viel Speicher die geladenen Modelle brauchen, lässt sich daraus nicht sicher ableiten. Geringere Präzision spart Platz auf der Festplatte und oft auch Speicher im Betrieb. Ob die Antwortqualität darunter leidet, hängt vom Modell, vom Quantisierungsverfahren und von der Aufgabe ab. Geh weder davon aus, dass die Antworten gleich gut bleiben, noch davon, dass die Ersparnis ohne Qualitätseinbussen zu haben ist.
Beim Speicherbedarf zählen nicht nur die geladenen Modellgewichte. Auch das Kontextfenster mit seinem Key-Value-Cache und alles, was sonst noch läuft, brauchen freien Speicher. Quantisierung allein garantiert also nicht, dass ein grösseres Modell in den Speicher passt. Mit der quantisierten Variante stehen die Chancen aber besser, als wenn du zuerst die Datei mit voller Präzision lädst.
Zwei Modellangaben, die zum falschen Download führen
Bei zwei Angaben im Modellkatalog lohnt sich ein genauer Blick: Sonst lädst du leicht etwas anderes herunter als geplant.
Falle eins. Google nennt für das Gemma 4 E2B auf seiner Modellkarte 2,3 Milliarden „effektive“ Sprachparameter. Das klingt nach einer kleinen Datei. Der Download bei Ollama ist jedoch 7,2 GB gross – fast so gross wie der Q4-Tag gemma4:12b mit 7,6 GB. Wenn du prüfst, ob ein Modell auf deinem Laptop Platz hat, orientiere dich an der Downloadgrösse, nicht an der Parameterzahl.
Falle zwei. Ohne genaue Modellangabe lädst du womöglich unbemerkt die falsche Variante herunter. Lädst du nur granite4.2 herunter, bekommst du das 8B-Modell mit 5,3 GB – nicht den 3B-Tag mit 2,2 GB aus Abschnitt 2. Mit dem blossen Familiennamen qwen3-embedding bekommst du das 8B-Modell mit 4,7 GB statt des in Abschnitt 8 verwendeten 0,6B-Tags mit 639 MB.
In beiden Fällen gilt: Lade immer den vollständigen Modell-Tag herunter, nicht nur den Familiennamen. Prüfe ausserdem die Downloadgrösse, bevor du annimmst, dass du die gewünschte Modellvariante testest.
Wie gross ist Ollamas Standard-Kontextfenster?
Im Katalog geben Werte wie 128K oder 256K Token an, wie viel Kontext ein Modell grundsätzlich verarbeiten kann. Ob dein Laptop mit 16 GB RAM dafür genug Speicher hat, lässt sich daraus nicht ablesen.
Ollama verwendet standardmässig ein Kontextfenster von 4.096 Token. Du kannst es vergrössern. Ein längerer Kontext und mehr parallele Anfragen erhöhen aber den Speicherbedarf. Die Einstellung num_ctx: 4096 aus Teil 2 der Reihe ist also nicht willkürlich gewählt: Sie entspricht diesem vorsichtigen Standardwert.
Starte ein neues Modell mit einem Kontextfenster von 4K bis 8K Token und nur einer aktiven Sitzung. Beobachte dabei, wie viel Arbeitsspeicher belegt ist. Vergrössere das Kontextfenster erst, wenn du gesehen hast, dass die Speicherbelegung stabil bleibt – nicht bloss, weil im Katalog ein höherer Wert steht.
Welches kleine KI-Modell passt zu deiner Spezialaufgabe?
Es gibt kein Spezialmodell, das für jede Aufgabe die beste Wahl ist. Was für dich passt, hängt von deiner Aufgabe ab. Deshalb lohnt es sich, einige kleine Modelle zu testen.
Programmieren: qwen2.5-coder:3b (1,9 GB) oder das grössere qwen2.5-coder:7b (4,7 GB). Beide stehen unter der Apache-2.0-Lizenz.
Mathe- oder Logikaufgaben mit klaren Vorgaben: phi4-mini:3.8b (2,5 GB) von Microsoft.
Fragen zu Bildern und Screenshots: gemma4:e2b (7,2 GB) oder gemma4:12b Q4 (7,6 GB). Beide stehen unter der Apache-2.0-Lizenz und unterstützen laut Katalog Text und Bilder als Eingabe.
Texte in mehreren Sprachen verfassen oder übersetzen: aya-expanse:8b (5,1 GB), entwickelt für 23 Sprachen.
Eine Lizenzbedingung bei Aya Expanse 8B ist zu wichtig für die Fussnote: Das Modell steht unter CC-BY-NC-4.0 mit zusätzlichen Bedingungen und ist für nicht kommerzielle Nutzung lizenziert. Betrachte es deshalb nicht als uneingeschränkt nutzbares Standardmodell neben den oben genannten Modellen mit Apache-Lizenz. Falls keine dieser vier Spezialaufgaben zu deinem Vorhaben passt, bleibt granite4.2:3b aus Abschnitt 2 die Wahl für allgemeine Aufgaben, die Schlussfolgerungen erfordern.
Teste jedes Modell an deiner eigenen Aufgabe, bevor du dich festlegst. Wie schon beim allgemeinen Assistenten zählt, ob es dir dabei hilft – nicht sein Platz in einer fremden Bestenliste.
Erst testen, dann vertrauen: fünf Aufgaben für den Modellvergleich
Fünf kurze Tests sagen mehr über ein Modell aus als jede Katalogseite. Teste alle Kandidaten mit denselben fünf Aufgaben und deinem eigenen Material.
1. Eine Zusammenfassung mit Belegen. Gib dem Modell eine Notiz mit 250 Wörtern. Es soll daraus drei Aufgaben ableiten und zu jeder den Satz angeben, auf dem sie beruht. Markiere alle Aussagen, die die Notiz nicht belegt.
2. Strukturierte Daten entnehmen. Denk dir fünf Termine mit Namen und Datumsangaben aus. Lass das Modell die Termine als JSON mit genau den von dir vorgegebenen Feldern ausgeben. Gleiche alle fünf Einträge mit deiner Vorlage ab.
3. Code reparieren. Gib dem Modell eine kleine Funktion und einen Test, den sie nicht besteht. Prüfe, ob der Test mit der vom Modell korrigierten Funktion besteht. Verwende für alle verglichenen Modelle dasselbe Repository und denselben Kontext.
4. Übersetzung zwischen zwei Sprachen. Lass jemanden, der beide Sprachen fliessend beherrscht, prüfen, ob bei der Übersetzung eines realistischen Absatzes Namen, Zahlen und Nuancen erhalten bleiben. Beurteile die mehrsprachige Qualität niemals allein anhand eines englischsprachigen Prompts.
5. Eine Frage zu einem Bild, nur für Modelle, die Bilder verarbeiten können. Zeige dem Modell ein Diagramm oder einen Screenshot und stelle eine Frage, deren Antwort du überprüfen kannst. Prüfe, ob das Bild selbst übertragen wurde und nicht nur sein Dateiname.
Halte bei jedem Durchlauf fest, ob die Antwort mit der bekannten Lösung übereinstimmt, ob das Modell die Anweisungen befolgt und ob es etwas erfunden hat. Notiere ausserdem die Zeit bis zur ersten sichtbaren Ausgabe, die Gesamtdauer, die Tokenzahlen und ob das Modell auf CPU oder GPU lief. Bewerte Nutzen und Geschwindigkeit getrennt: Auch Token für interne Schlussfolgerungen kosten Zeit, obwohl du sie nie zu sehen bekommst.
Dokumente lokal durchsuchen: eine kleine RAG-Erweiterung
Das Embedding-Modell aus Abschnitt 2 hat eine Aufgabe: Es wandelt Text in Vektoren um, die eine Suchanwendung durchsuchen kann. Fragen beantwortet es nicht selbst.
Die Reihenfolge ist wichtig: Zuerst werden deine Dateien in Abschnitte aufgeteilt. Das Embedding-Modell wandelt jeden Abschnitt in einen Vektor um, der in einem lokalen Vektorspeicher abgelegt wird. Auch deine Suchanfrage wird in einen Vektor umgewandelt. Die Suche ruft die am besten passenden Abschnitte ab. Erst dann beantwortet ein Chatmodell deine Frage anhand der gefundenen Stellen und zitiert sie.
Das Chatmodell wurde nie mit deinen Dokumenten trainiert. Wenn du eine Frage stellst, bekommt es nur das zu sehen, was ihm die Suche in diesem Moment übergibt.
Ein kleiner Test zeigt dir ohne grossen Einrichtungsaufwand, wie das funktioniert: Indexiere fünf Notizen, die du schon hast. Stell eine Frage, deren Antwort in einer der Notizen steht, und eine zweite, die sich mit keiner der fünf beantworten lässt. Funktioniert die Einrichtung, findet und zitiert das System bei der ersten Frage die passende Textstelle. Bei der zweiten weist es darauf hin, dass dafür ein Beleg fehlt, statt eine Antwort zu erfinden. Beurteile die Suchtreffer und die fertige Antwort getrennt.
Prüfe vor dem Download den vollständigen Tag des Embedding-Modells: embeddinggemma:300m oder qwen3-embedding:0.6b. Ein unvollständiger Tag kann wie in Abschnitt 4 zum falschen Download führen.
Warum weniger aktive Parameter nicht automatisch Speicherplatz sparen
Ein Modell mit einer Bezeichnung wie „26B A4B“ aktiviert für jedes erzeugte Token nur einen Teil seiner Parameter. Die vollständigen Gewichte des 26B-Modells müssen dennoch irgendwo gespeichert oder laufend eingelesen werden. Weniger aktive Parameter bedeuten deshalb nicht automatisch eine kleinere Datei oder einen geringeren Speicherbedarf im Betrieb.
Neu gemessene Benchmarkwerte enthält dieses Toolkit nicht. Zahlen aus anderen Quellen gelten nur für den jeweiligen Aufbau und die verwendete Hardware. So berichtet eine Person von rund 18,5 Token pro Sekunde bei einem ungewöhnlichen Testaufbau mit einem 26B-MoE-Modell, einer älteren CPU und einer GPU mit 6 GB VRAM. Für andere Modelle mit derselben Bezeichnung ist dieser Wert kein allgemeiner Richtwert.
Die Laptops, auf denen wir dieses Toolkit getestet haben
Wir haben das Toolkit auf zwei aktuellen Laptops getestet – denselben wie in Teil 2 dieser Reihe: einem Apple-Silicon-Einstiegsmodell und einer Windows-Workstation mit eigenem Grafikspeicher. Beide sind refurbished (professionell geprüft, gereinigt und wiederaufbereitet), und für beide gilt bei refurbed eine Garantie von zwölf Monaten. Beide können das Toolkit oben problemlos ausführen, ein Modell nach dem anderen.
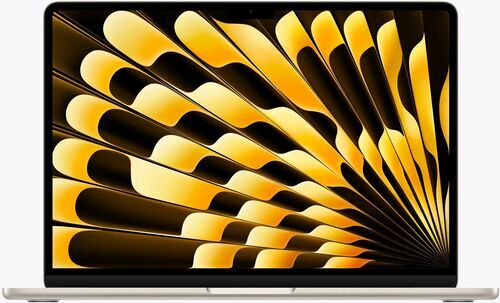
Das MacBook Air (2026) mit 13 Zoll und M5-Chip hat standardmässig 16 GB gemeinsam genutzten Speicher und lässt sich mit bis zu 32 GB konfigurieren. Das Dell Precision 7730 hat 32 GB Systemspeicher sowie 6 GB dedizierten NVIDIA-Grafikspeicher (VRAM). Die beiden Speicherbereiche sind getrennt und lassen sich nicht zu einem gemeinsamen Speicher zusammenfassen.
Die beiden Laptops sind hier keine Kaufempfehlung. Auf ihnen haben wir das Toolkit für diesen Ratgeber getestet. So kannst du deinen Laptop mit konkreter Hardware vergleichen – statt mit einem Marketing-Datenblatt.

Lizenzen prüfen und die Modellauswahl klein halten
Eine Lizenz gilt für das jeweilige Modell, nicht pauschal für die Modellfamilie. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B und Gemma 4 E2B stehen unter der Apache-2.0-Lizenz. Für Aya Expanse 8B gilt, wie in Abschnitt 6 erwähnt, CC-BY-NC-4.0 mit zusätzlichen Bedingungen für nicht kommerzielle Nutzung. Modellgewichte herunterladen zu können, eine urheberrechtliche Erlaubnis zu ihrer Nutzung zu haben und das zugrunde liegende Modell zu „besitzen“ – das sind drei verschiedene Dinge. Sieh dir deshalb die aktuelle Modellkarte zum vollständigen Tag an, den du herunterlädst, statt nur die Angaben zur Modellfamilie.
Einmal auswählen genügt nicht, damit dein Toolkit klein bleibt. Mit ollama rm entfernst du einen Download, der sich nicht bewährt hat, zum Beispiel mit ollama rm aya-expanse:8b, sobald du weisst, dass du dieses Modell nicht nutzen wirst. ollama ls zeigt dir, was tatsächlich auf der Festplatte liegt; ollama ps zeigt, was gerade geladen ist. Modellkataloge ändern sich. Geh deine Auswahl deshalb immer wieder durch, statt dich auf eine Entscheidung von vor Monaten zu verlassen.
Auch kleine Modelle können Textstellen erfinden, bei Übersetzungen Nuancen übersehen oder Code schreiben, der richtig aussieht und trotzdem einen Test nicht besteht. Betrachte jede Empfehlung hier als Ausgangspunkt für eigene Tests, nicht als Ersatz für eine fachliche Prüfung, wenn es darauf ankommt.
Die besten kleinen KI-Modelle lokal nutzen: häufige Fragen
Kann ich alle drei Modelle des Toolkits gleichzeitig ausführen? Auf einem Laptop mit 16 GB RAM läuft das wahrscheinlich nicht ohne Engpässe. Lade jeweils das Modell für deine aktuelle Aufgabe und wechsle danach, statt den allgemeinen Assistenten, das Spezialmodell und das Embedding-Modell gleichzeitig im Speicher zu halten.
Brauche ich für das Embedding-Modell eine GPU? Nein. embeddinggemma:300m ist klein genug, um es allein auf der CPU zu testen. Miss trotzdem die Laufzeit, statt mit einer sofortigen Verarbeitung zu rechnen.
Liefert ein grösseres Modell immer die bessere Antwort? Nein. Ob ein 4B- oder ein 9B-Modell besser abschneidet, hängt von der Aufgabe ab. Deshalb setzt Abschnitt 7 auf fünf Tests statt auf eine einzige Zahl aus einer Bestenliste.
Reicht ein Q4-Download aus? Das hängt von der Aufgabe ab. Wenn dein Laptop genug Speicher hat, um beide Varianten auszuführen, vergleiche einen Q4-Tag mit dem entsprechenden Q8-Tag in drei eigenen Tests, wie in Abschnitt 3 beschrieben.
Kann ich Aya Expanse für ein kommerzielles Projekt nutzen? Nicht ohne Weiteres. Die CC-BY-NC-4.0-Lizenz deckt die nicht kommerzielle Nutzung ab; hinzu kommen weitere Bedingungen. Prüfe die aktuelle Modellkarte, bevor du davon ausgehst, dass eine kommerzielle Nutzung erlaubt ist.
Braucht das Embedding-Modell nach dem Download eine Internetverbindung? Nein. Sobald die Modellgewichte auf der Festplatte liegen, läuft es wie alle anderen Modelle in diesem Toolkit offline.
Jetzt bist du dran: Installiere die Modelle, teste sie und behalte, was sich bewährt
Installiere den 4B-Assistenten und ein Spezialmodell, das zu einer deiner Aufgaben passt. Nutze dafür den Laptop, dessen Speicherbedarf du in Teil 1 eingeschätzt und den du in Teil 2 eingerichtet hast. Teste beide Modelle mit drei eigenen Fragen nach dem Muster aus Abschnitt 7. Behalte das Modell, das dir hilft – das andere entfernst du mit ollama rm. Über den Kauf von zusätzlichem Speicher solltest du erst nachdenken, wenn du bei einer konkreten Aufgabe feststellst, dass der vorhandene Speicher der Engpass ist – nicht allein aufgrund eines Datenblatts.
Damit endet unsere dreiteilige Reihe. Falls dein Laptop zunächst mehr Speicher braucht, ist die Laptop-Kategorie ein sinnvoller Ausgangspunkt.

Erstmals zum Newsletter anmelden, CHF 15 sparen!
Verpasse kein Angebot mehr.
Informationen über die Verwendung personenbezogener Daten findest du in unserer Datenschutzerklärung.
Hol dir die refurbed-App
Für iOS und Android


Anmeldung bestätigen
Klicke auf den Link in unserer Bestätigungs-Mail, um deinen Gutschein zu erhalten. Er gilt ab einem Einkauf von 200 CHF.
- © Refurbed Marketplace GmbH
- Barrierefreiheit
- AGB
- Datenschutz
- Impressum
- Rechtliche Hinweise
- Cookie Policy